Respuesta corta
Un 100 en SEO en Lighthouse demuestra que una página supera diez comprobaciones. No dice nada de lo que ocurre entre tus páginas. El 8 de noviembre de 2026, mi portafolio en Next.js obtenía 100 en las seis plantillas de página que analicé, y aun así 61 de sus 89 URL no eran accesibles siguiendo enlaces desde la portada. Este tipo de problema solo se ve rastreando el sitio entero, y el script que usé está más abajo. Las correcciones son demasiado recientes para tener datos de tráfico, así que no anuncio ninguna mejora.
Qué audité y cómo
El sitio es el que estás leyendo: Next.js 15 con el App Router, páginas estáticas, tres idiomas y algunos miniproyectos, alojado en Vercel. El artículo sobre cómo está construido explica su arquitectura.
La auditoría combinó cuatro fuentes:
- Lighthouse 12.8.2, en móvil, sobre seis plantillas de página en producción: SEO 100, accesibilidad 100, buenas prácticas 100, rendimiento 99.
- Un rastreo de las 89 URL del sitemap: códigos HTTP, metadatos, hreflang, datos estructurados y enlaces internos.
- La lectura del código y de los artículos, más una prueba de los 45 enlaces externos que citan.
- La documentación de Google y de Next.js, para separar las reglas reales de las costumbres del oficio.
Tiene tres límites:
- No usa Search Console ni los datos de campo de CrUX. Describe las condiciones de posicionamiento, no las posiciones ni el tráfico.
- Las medidas de «antes» vienen de producción, y las de «después», de un build local de la versión corregida.
- Hice la auditoría y las correcciones con un agente de IA (Claude Code), y después revisé y validé el resultado. Los errores descritos son realmente los de mi sitio.
Qué comprueba realmente Lighthouse
La categoría SEO de Lighthouse tiene diez auditorías puntuadas, y cada una mira una sola página:
| Auditoría | Qué verifica |
|---|---|
is-crawlable | Nada impide indexar la página |
http-status-code | La página responde con un código de éxito |
document-title | La página tiene un <title> |
meta-description | La página tiene una meta descripción |
link-text | Los textos de enlace son descriptivos |
crawlable-anchors | Las etiquetas <a> presentes tienen un href utilizable |
robots-txt | El archivo robots.txt es válido |
image-alt | Las imágenes tienen atributo alt |
hreflang | Los códigos de idioma son válidos y las URL, absolutas |
canonical | El canonical es válido y no presenta conflictos |
Una undécima, structured-data, se hace a mano y no cuenta en la puntuación.
La herramienta no lo oculta. Su categoría SEO habla de consejos básicos («basic search engine optimization advice») y recuerda que hay «many additional factors Lighthouse does not score». Una comprobación página por página no puede responder a estas preguntas:
- ¿Algún enlace lleva a esta página?
- ¿Dos páginas tienen el mismo título?
- ¿La versión española remite a la francesa?
- ¿Mis enlaces internos llevan a páginas que excluí del índice?
- ¿El código publicado en mis artículos sigue funcionando?
Ocho hallazgos, del más importante al menos importante
1. Tres islas, una por idioma
Partiendo de /, un rastreador encontraba las 28 páginas en inglés y se detenía ahí. Desde /fr encontraba las 35 páginas en francés, y desde /es, las 26 en español. En todo el sitio, ninguna etiqueta <a> conectaba dos idiomas.
La causa cabe en un elemento HTML: mi selector de idioma era un <button>. Para un visitante funcionaba muy bien, sin recargar la página. Para un rastreador no ofrecía ningún camino. crawlable-anchors no tenía nada que señalar, porque solo comprueba las etiquetas <a> que existen.
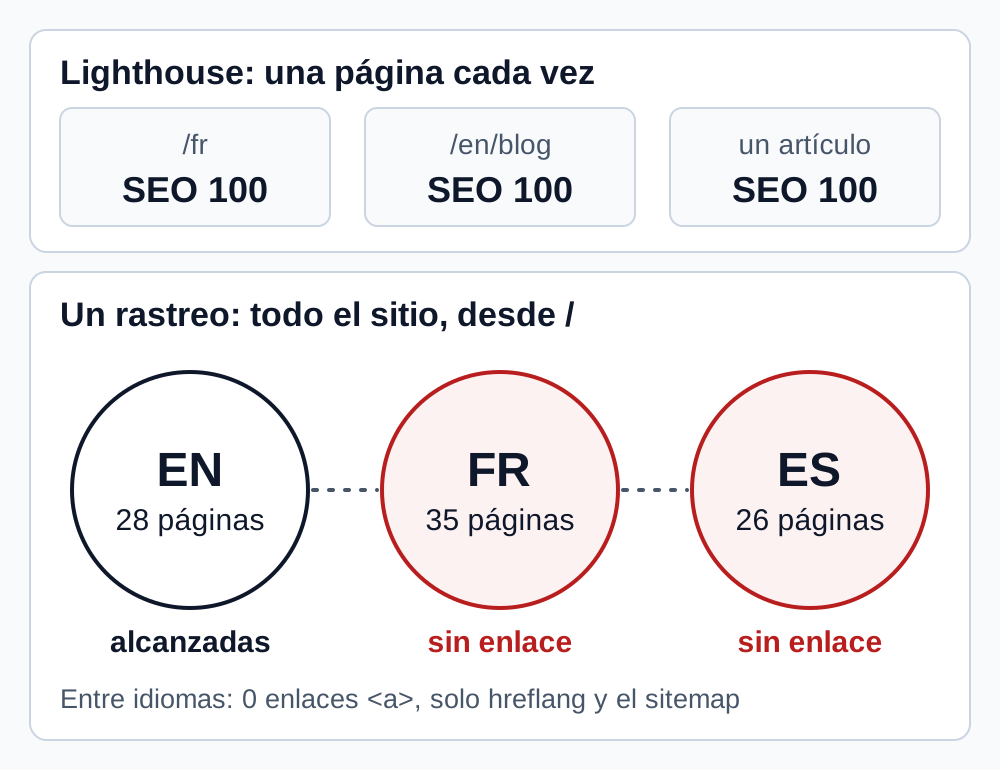
Esas páginas no eran invisibles, porque el sitemap y hreflang permiten descubrirlas. Sin los datos de Search Console no puedo decir cuánto costó esta situación. Aun así, la recomendación de Google es clara: «Consider adding hyperlinks to other language versions of a page.» Hreflang declara una equivalencia, mientras que un enlace ofrece un camino, tanto al rastreador como al visitante que llega al idioma equivocado.
La corrección mantiene el comportamiento al hacer clic y añade un enlace real:
// components/language-provider.tsx
export function LanguageLink({
  locale,
  onNavigate,
  ...props
}: ComponentProps<"a"> & { locale: BlogLanguage; onNavigate?: () => void }) {
  const { changeLanguage } = useLanguage();

  return (
    <a
      {...props}
      hrefLang={locale}
      lang={locale}
      onClick={(event) => {
        // Cmd/Ctrl-clic o Mayús-clic: el navegador abre el enlace como siempre
        if (event.metaKey || event.ctrlKey || event.shiftKey || event.altKey) return;
        event.preventDefault();
        onNavigate?.();
        changeLanguage(locale); // la misma transición de antes, sin recargar
      }}
    />
  );
}
Los artículos necesitan un paso más. Su slug cambia de un idioma a otro, y la cabecera solo conoce la traducción en el cliente. Por eso añadí, bajo el título de cada artículo traducido, una línea renderizada por el servidor: «También disponible en English · Français». Le sirve al lector, y el rastreador puede seguirla.
Hreflang no era el problema. En el App Router se configura con alternates, y cada versión debe citarse a sí misma además de citar a las demás:
export async function generateMetadata(): Promise<Metadata> {
  return {
    alternates: {
      canonical: "https://www.example.com/es/blog/mi-articulo",
      languages: {
        es: "https://www.example.com/es/blog/mi-articulo",
        en: "https://www.example.com/en/blog/my-article",
        fr: "https://www.example.com/fr/blog/mon-article",
        "x-default": "https://www.example.com/en/blog/my-article",
      },
    },
  };
}
2. Un nombre de sitio declarado en la dirección equivocada
El nombre que aparece sobre un resultado de Google se apoya, entre otras cosas, en el marcado WebSite, y la regla es precisa: «The WebSite structured data must be on the home page of the site.» Google define además esa página: «By home page, we mean the domain or subdomain level root URI.» E incluso añade: «Google Search does not support site names at the subdirectory level.»
En las 89 URL, mi marcado declaraba /en, /fr o /es según el idioma: tres sitios distintos y ninguno en la raíz. El JSON-LD seguía siendo válido y Lighthouse no puntúa los datos estructurados, así que nada podía señalarlo.
Lo sustituí por una sola entidad, idéntica en todos los idiomas:
// lib/seo/jsonld.ts
const WEBSITE_ID = `${SITE_URL}/#website`;

export function websiteNode(): Node {
  return {
    "@type": "WebSite",
    "@id": WEBSITE_ID,
    url: `${SITE_URL}/`,
    name: SITE_NAME,
    inLanguage: LOCALES.map((locale) => LOCALE_TO_LANGUAGE_TAG[locale]),
    publisher: { "@id": PERSON_ID },
  };
}
Un detalle propio de este sitio: / sirve inglés y su canonical apunta a /en. Google pide precisamente el mismo marcado en todos los duplicados: «make sure that you're using the same structured data on all page duplicates, not just on the canonical page.» El efecto solo se podrá observar después del despliegue, porque es Google quien elige el nombre que muestra.
3. 61 títulos alargados sin que el código lo muestre
Este sitio sigue una regla simple: el seoTitle de un artículo no pasa de 60 caracteres. Se cumplía, y aun así 61 de los 89 títulos renderizados superaban ese límite, hasta llegar a 80 caracteres. La línea responsable está en el layout raíz:
// lib/root-metadata.ts
title: {
  default: `${SITE_NAME} — Full-Stack Developer`,
  template: `%s | ${SITE_NAME}`,
},
title.template añade la marca a cada página sin que el código de la página lo deje ver. Por eso hay que leer los títulos renderizados, no los del código. Es uno de los puntos de la API de metadata de Next.js que más fácilmente se pasan por alto.
No es una penalización. Google aclara que no hay límite de longitud («there's no limit on how long a <title> element can be») y que corta el título si hace falta («truncated in Google Search results as needed, typically to fit the device width»). El riesgo se limita a perder el final del título, así que la corrección solo mantiene la marca si cabe:
// lib/seo/metadata.ts
const MAX_TITLE_LENGTH = 60;
const BRAND_SUFFIX = ` | ${SITE_NAME}`;

export function resolveTitle(title: string, absolute = false): Metadata["title"] {
  return absolute || title.length + BRAND_SUFFIX.length > MAX_TITLE_LENGTH
    ? { absolute: title } // ignora el template del layout
    : title;
}
El umbral de 60 es una convención de este sitio, no una regla de Google.
4. Enlaces a páginas que yo mismo había excluido
Dieciocho artículos de este blog están en noindex: temas de tendencia demasiado genéricos para merecer un lugar en el índice. Aun así, 9 enlaces en 7 artículos indexables llevaban a 6 de ellos. Esos enlaces respondían 200, así que ninguna comprobación de página podía señalarlos.
No hay ninguna penalización de por medio, pero el mensaje es contradictorio: le pido a Google que ignore una página mientras envío a ella a los lectores de mis mejores artículos. Sustituí esos enlaces por una página indexable que sirve mejor a la idea, o los eliminé.
Este problema vuelve con cada artículo nuevo, así que lo convertí en un error bloqueante de la comprobación que se ejecuta en CI:
// scripts/check-seo.mjs
} else if (!validPaths.has(pathname) && !publicFile(pathname)) {
  error(file, `broken internal link: ${href}`);
} else if (!fromNoindex && isNoindexArticle(pathname)) {
  error(file, `link to a noindex article: ${href}`);
}
5. Tres páginas temáticas para el mismo contenido
El blog en francés tenía cuatro páginas temáticas. Tres de ellas compartían entre 9 y 10 de sus 12 artículos, y dos solo recibían un enlace interno. Tres direcciones para casi la misma lista son justo el tipo de página que no aporta nada.
Fusioné dos de ellas en la de agentes de IA, conservé su texto útil y añadí redirecciones permanentes, que Next.js sirve como 308:
// next.config.ts
...[
  ...getMergedPageRedirects(),
  ...getMergedTopicHubRedirects(),
  ...getSectionRedirects(),
].map((redirect) => ({ ...redirect, permanent: true })),
Quedan dos páginas temáticas realmente distintas: agentes de IA y Next.js.
6. Código publicado que ya no funcionaba
Es el hallazgo menos halagador, y ninguna herramienta de SEO podía hacerlo:
- Mi tutorial de LangChain importaba
AgentExecutorycreate_react_agentdesdelangchain.agents, lo que falla con LangChain 1.x. También enlazaba a un repositorio de GitHub que devolvía 404. - El artículo sobre SmartDAM llamaba a
api-inference.huggingface.co, un host que ya no existe. - El artículo sobre este portafolio aún describía Next.js 13 y un script de sitemap desaparecido hacía tiempo.
Google lo pregunta sin rodeos: «Does the content have any easily-verified factual errors?» Y un desarrollador cuyo copiar y pegar falla tiene pocos motivos para volver.
Reescribí el tutorial para LangChain 1.x y ejecuté cada archivo en un entorno de Python limpio, con un modelo simulado y bases de datos SQLite y PostgreSQL reales. Al ejecutarlo apareció lo que la revisión había dejado pasar:
InMemoryVectorStorenecesitanumpy, que faltaba en el comando de instalación.- Un cliente creado al importar fallaba antes de que se ejecutara
load_dotenv(). - Por defecto,
ModelRetryMiddlewareconvierte el fallo del modelo en un mensaje de IA, de modo que la API del tutorial respondía 200 con el modelo caído.
En SmartDAM, sustituí la URL por la del router de Hugging Face, sin probarla con un token real. Una nota con fecha lo indica en el artículo.
7. Errores que un corrector simple no ve
En español, muchas palabras habían perdido el acento: «arnes» en lugar de «arnés», «se presento» en lugar de «se presentó». En los artículos en francés, un control con diccionario marcó más de 200 apariciones, y lo peor eran los verbos con un acento de más, porque cada palabra existe y el diccionario no dice nada. El historial de git muestra de dónde venían: una antigua pasada automática que añadía acentos los introdujo en un mismo commit.
Google pregunta: «Does the content have any spelling or stylistic issues?» Las corregí una por una, leyendo cada frase afectada, no reemplazando a ciegas, porque muchas palabras marcadas son correctas. En español, «integra» o «publica» son formas verbales reales: cambiarlas sin leer la frase habría creado errores nuevos.
8. Las pequeñas incoherencias
| Hallazgo | Corrección |
|---|---|
Dominio sin www en 307, temporal, con dos saltos desde http:// | Se ajusta en el panel de Vercel, no en el código |
Seis enlaces internos a /, que no es una URL canónica | Enlaces directos a /en |
/fr/projets, /en/projects, /es/proyectos y /fr/blog/themes en 404 | Redirecciones 308 a la lista correspondiente |
| Descripciones de OpsPilot de 183 y 172 caracteres, título sin tema | Título y descripción escritos para la búsqueda, página sin cambios |
Sitemap sin x-default, aunque el HTML lo tenía | Añadido |
llms.txt, ai-profile.json y feeds RSS indexables | X-Robots-Tag: noindex, archivos todavía accesibles |
| Una rama según el user-agent en el middleware | Eliminada: la respuesta depende de Accept-Language, nunca del robot |
| Un componente de cliente que importaba todas las landing pages para tres etiquetas | Etiquetas pasadas como prop, JavaScript de la página del blog de 17,7 a 4,8 KB |
Lo que medí y dejé como estaba
Una auditoría también sirve para no tocar lo que no lo justifica.
inlineCss. Esta opción coloca el CSS en el HTML, y además sigue en el flujo RSC, lo que parece un desperdicio. Comparé ambos ajustes en un build local, con cinco mediciones por variante. El FCP gana de 50 a 70 ms de forma estable, y la diferencia en el LCP se pierde en el ruido de medición, a cambio de 12 KB más en la portada y 48 KB más en un artículo. El HTML queda muy por debajo del límite de 2 MB de Googlebot. Mantuve la opción.
Las FAQ. Google ya no muestra resultados enriquecidos de FAQ desde mayo de 2026, así que añadir una FAQ para ocupar más espacio en los resultados ya no sirve de nada. Conservo las que responden a preguntas reales.
llms.txt. Para sus funciones de IA, Google es explícito: «You don't need to create new machine readable files, AI text files, or markup». Conservo este archivo porque se genera solo, sin esperar ningún efecto.
IndexNow. Un script manual avisa a Bing y a los demás buscadores participantes después de un despliegue. Google no participa, y no encontré pruebas de ningún efecto en las citas de los asistentes de IA.
La redirección de idioma en /. Google aconseja evitar las redirecciones automáticas («Avoid automatically redirecting»). La mantengo solo en la raíz: un navegador configurado en francés o en español va a su idioma, y un rastreador, que no envía ninguna preferencia, recibe inglés. Cada versión conserva su propia URL, accesible directamente y mediante un enlace. Es un compromiso asumido.
Antes y después
La columna «Antes» viene de producción, y la columna «Después», de un build local de la versión corregida.
| Comprobación | Antes | Después |
|---|---|---|
| SEO en Lighthouse, seis plantillas de página | 100 | 100 |
| URL inaccesibles desde la portada | 61 de 89 | 0 de 90 |
| Títulos de más de 60 caracteres | 61 | 0 |
| Descripciones fuera de 70 a 160 caracteres | 2 | 0 |
Páginas que declaran WebSite fuera de la raíz | 89 | 0 |
| Enlaces a páginas noindex | 9 | 0 |
Enlaces internos a / | 6 | 0 |
La puntuación no se movió, y de eso se trata: nunca vio la diferencia. Esta tabla describe el estado del sitio, no un resultado de búsqueda. Las posiciones y el tráfico se verán en Search Console, varias semanas después del despliegue.
Un script para auditar tu sitio Next.js
Nada en este script es propio de Next.js: funciona en cualquier sitio con un sitemap. Cópialo en un archivo seo-audit.mjs y ejecútalo:
# En producción
node seo-audit.mjs https://www.example.com

# En un build local: el script sustituye el origen del sitemap por esta dirección
npx next build && npx next start -p 3000
node seo-audit.mjs http://localhost:3000
Lee el sitemap, incluido un índice de sitemaps, pide cada página sin ejecutar JavaScript y aplica las reglas de este artículo. La versión que se ejecuta en este sitio tiene algunas más, como el peso del HTML y la profundidad de clics.
// seo-audit.mjs: rastrea un sitemap e informa de lo que una puntuación página por página no puede ver.
// node seo-audit.mjs https://www.example.com
// node seo-audit.mjs http://localhost:3000 un build local cuyo sitemap lista las URL de producción
// Sin dependencias, Node 20 o superior. Lee el HTML que envía el servidor y no ejecuta JavaScript.
const base = (process.argv[2] ?? "http://localhost:3000").replace(/\/$/, "");
const problems = new Map();
const report = (rule, detail) => problems.set(rule, [...(problems.get(rule) ?? []), detail]);
const attr = (tag = "", name) => tag.match(new RegExp(`\\s${name}="([^"]*)"`, "i"))?.[1];
const tags = (html, name) => html.match(new RegExp(`<${name}\\b[^>]*>`, "gi")) ?? [];
const decode = (text = "") =>
text
.replace(/&#x([0-9a-f]+);/gi, (_, hex) => String.fromCodePoint(parseInt(hex, 16)))
.replace(/&#(\d+);/g, (_, code) => String.fromCodePoint(Number(code)))
.replace(/"/g, '"')
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/&/g, "&");
// Una misma página siempre debe tener la misma clave: sin parámetros, sin fragmento, sin barra final
const clean = (url, from) => {
const { origin, pathname } = new URL(decode(url), from);
return origin + pathname.replace(/(?<=.)\/$/, "");
};
const local = (url) => base + new URL(url).pathname;
async function get(url, redirect = "manual") {
const response = await fetch(url, { redirect, headers: { "user-agent": "SeoAudit/1.0" } });
return {
status: response.status,
location: response.headers.get("location"),
robots: response.headers.get("x-robots-tag") ?? "",
html: await response.text(),
};
}
async function readSitemap(url) {
const { html: xml } = await get(url, "follow");
const entries = [...xml.matchAll(/<loc>\s*([^<\s]+)\s*<\/loc>/g)].map((match) => clean(match[1]));
if (!xml.includes("<sitemapindex")) return entries;
return (await Promise.all(entries.map((entry) => readSitemap(local(entry))))).flat();
}
const urls = [...new Set(await readSitemap(`${base}/sitemap.xml`))];
if (urls.length === 0) throw new Error("Ninguna URL en el sitemap");
const origin = new URL(urls[0]).origin;
function parse(url, { html, robots }) {
const links = tags(html, "link");
const meta = (name) => attr(tags(html, "meta").find((tag) => attr(tag, "name") === name), "content");
const targets = tags(html, "a").flatMap((tag) => {
try {
const target = clean(attr(tag, "href") ?? "", url);
return target.startsWith(`${origin}/`) || target === origin ? [target] : [];
} catch {
return [];
}
});
return {
title: decode(html.match(/<title\b[^>]*>([\s\S]*?)<\/title>/i)?.[1]),
description: decode(meta("description")),
noindex: /noindex/i.test(`${meta("robots")} ${robots}`),
canonicals: links.filter((tag) => attr(tag, "rel") === "canonical").map((tag) => clean(attr(tag, "href"), url)),
alternates: links.filter((tag) => attr(tag, "hreflang")).map((tag) => clean(attr(tag, "href"), url)),
h1: tags(html, "h1").length,
links: [...new Set(targets)],
};
}
function checkStructuredData(url, html) {
for (const [, json] of html.matchAll(/<script[^>]*ld\+json[^>]*>([\s\S]*?)<\/script>/gi)) {
try {
const nodes = [JSON.parse(json)].flat().flatMap((item) => item["@graph"] ?? [item]);
for (const node of nodes) {
if (node["@type"] === "WebSite" && new URL(node.url).pathname !== "/") {
report("Marcado WebSite fuera de la raíz del dominio", `${url} (${node.url})`);
}
}
} catch {
report("JSON-LD no válido", url);
}
}
}
// Una página cada vez
const pages = new Map();
const seen = new Map();
for (const url of urls) {
const response = await get(local(url));
if (response.status !== 200) {
report("URL del sitemap que no responde 200", `${url} (${response.status})`);
continue;
}
const page = parse(url, response);
pages.set(url, page);
checkStructuredData(url, response.html);
if (page.noindex) report("Página noindex en el sitemap", url);
if (page.canonicals.length !== 1 || page.canonicals[0] !== url) report("Canonical distinto de la URL de la página", url);
if (page.h1 !== 1) report("Página sin un único H1", `${url} (${page.h1})`);
if (page.title.length > 60) report("Título de más de 60 caracteres (riesgo de corte, no una penalización)", `${url} (${page.title.length})`);
const length = page.description.length;
if (length > 0 && (length < 70 || length > 160)) report("Descripción fuera de 70 a 160 caracteres", `${url} (${length})`);
for (const field of ["title", "description"]) {
const key = `${field}:${page[field]}`;
if (!page[field]) report(`Etiqueta ausente: ${field}`, url);
else if (seen.has(key)) report(`Etiqueta duplicada: ${field}`, `${url} = ${seen.get(key)}`);
else seen.set(key, url);
}
}
// hreflang: cada versión se cita a sí misma, y las versiones citadas deben citarla también
for (const [url, page] of pages) {
if (page.alternates.length > 0 && !page.alternates.includes(url)) report("Grupo hreflang que no cita la propia página", url);
for (const other of page.alternates) {
if (!pages.has(other)) report("Destino hreflang fuera del sitemap", `${url} -> ${other}`);
else if (!pages.get(other).alternates.includes(url)) report("hreflang no recíproco", `${url} -> ${other}`);
}
}
// Enlaces internos: ¿adónde llevan?
const answers = new Map();
for (const [url, page] of pages) {
for (const target of page.links.filter((link) => !pages.has(link))) {
if (!answers.has(target)) answers.set(target, await get(local(target)));
const answer = answers.get(target);
if (answer.status >= 400) report("Enlace a una página inexistente", `${url} -> ${target} (${answer.status})`);
else if (answer.status >= 300) report("Enlace a una redirección", `${url} -> ${target} (${answer.status} a ${answer.location})`);
else if (/<html/i.test(answer.html.slice(0, 500))) {
if (parse(target, answer).noindex) report("Enlace a una página noindex", `${url} -> ${target}`);
else report("Página indexable ausente del sitemap", `${url} -> ${target}`);
}
}
}
// ¿Qué páginas alcanza un rastreador siguiendo los enlaces desde la portada?
const home = parse(`${origin}/`, await get(`${base}/`, "follow"));
const reached = new Set(home.links);
for (const queue = [...reached]; queue.length > 0; ) {
for (const target of pages.get(queue.shift())?.links ?? []) {
if (!reached.has(target)) {
reached.add(target);
queue.push(target);
}
}
}
for (const url of pages.keys()) {
if (!reached.has(url) && url !== `${origin}/`) report("Página a la que ningún enlace lleva desde la portada", url);
}
for (const [rule, items] of problems) {
console.log(`\n${rule}: ${items.length}`);
for (const item of items.slice(0, 5)) console.log(` ${item}`);
if (items.length > 5) console.log(` ... y ${items.length - 5} más`);
}
const total = [...problems.values()].reduce((sum, items) => sum + items.length, 0);
console.log(`\n${urls.length} URL, ${total} problemas`);
process.exitCode = total > 0 ? 1 : 0;
Esta es su salida, abreviada, sobre la versión anterior de este sitio. La regla «Página indexable ausente del sitemap» señala aquí los enlaces a / del hallazgo 8.
Marcado WebSite fuera de la raíz del dominio: 89
  https://www.mouhssinelakhili.com/en (https://www.mouhssinelakhili.com/en)
  https://www.mouhssinelakhili.com/fr (https://www.mouhssinelakhili.com/fr)
  ...

Título de más de 60 caracteres (riesgo de corte, no una penalización): 61
  https://www.mouhssinelakhili.com/fr/developpeur-full-stack-javascript-typescript-paris (67)
  https://www.mouhssinelakhili.com/es/ingeniero-full-stack-paris (64)
  ...

Descripción fuera de 70 a 160 caracteres: 2
  https://www.mouhssinelakhili.com/fr/projets/opspilot (183)
  https://www.mouhssinelakhili.com/es/proyectos/opspilot (172)

Página indexable ausente del sitemap: 2
  https://www.mouhssinelakhili.com/en/blog/github-copilot-cloud-agent-explained-april-2026 -> https://www.mouhssinelakhili.com/
  https://www.mouhssinelakhili.com/en/blog/agent-command-centers-2026-developer-productivity -> https://www.mouhssinelakhili.com/

Enlace a una página noindex: 9
  https://www.mouhssinelakhili.com/en/blog/agent-command-centers-2026-developer-productivity -> https://www.mouhssinelakhili.com/en/blog/vibe-coding-field-report-2026
  https://www.mouhssinelakhili.com/en/blog/ai-orchestrator-battle-guide-2026 -> https://www.mouhssinelakhili.com/en/blog/ai-in-2026-autonomous-ai-agents-and-human-ai-collaboration
  ...

Página a la que ningún enlace lleva desde la portada: 61
  https://www.mouhssinelakhili.com/fr
  https://www.mouhssinelakhili.com/es
  ...

89 URL, 224 problemas
El script termina con el código de salida 1 si encuentra un problema, así que también puede bloquear una CI. Tiene sus límites:
- Solo sigue los enlaces de las páginas del sitemap y no prueba ningún enlace externo.
- No lee
robots.txt. - Ve el HTML del servidor: una página renderizada en el cliente le parecerá casi vacía, lo que ya es información útil.
- Los umbrales de 60 y de 70 a 160 caracteres son referencias, no reglas de Google. Ajústalos.
- Envía las peticiones de una en una para no sobrecargar tu alojamiento. Ejecútalo solo en tus propios sitios.
Checklist de SEO para un sitio Next.js
-
Rastrea desde la portada. Toda página del sitemap debe ser accesible mediante enlaces.
-
Busca tu selector de idioma en el HTML. Debe contener un
<a href>, porque un<button>o un<select>no ofrece ningún camino. -
Lee tus títulos renderizados, porque
title.templatelos alarga:curl -s https://www.example.com/page | grep -o '<title>[^<]*</title>' -
Revisa el marcado
WebSite. Suurldebe ser la raíz del dominio, con el mismo marcado en todas las versiones de la portada. -
Prueba las redirecciones de dominio. Busca un solo salto permanente (301 o 308):
curl -sI http://example.com | grep -iE '^(HTTP|location)' curl -sI https://example.com | grep -iE '^(HTTP|location)' -
Comprueba que el contenido llega sin JavaScript. Un resultado de 0 indica un problema:
curl -s https://www.example.com/page | grep -c "una frase de la página" -
Rechaza en CI los enlaces a páginas noindex. Son los más fáciles de volver a introducir.
-
Ejecuta el código de tus tutoriales en un entorno limpio, al menos con cada versión mayor de las bibliotecas que citan.
-
Mide antes de optimizar. Un ajuste como
inlineCssse compara, no se adivina. -
Contrasta todo con Search Console. Las páginas indexadas y las consultas reales siguen siendo la única medida del resultado.
Preguntas frecuentes
¿Qué es el SEO en Next.js?
Es hacer que las páginas de una aplicación Next.js se puedan rastrear, entender e indexar: HTML que llega desde el servidor, metadatos con la API Metadata, sitemap y enlaces internos. El framework resuelve bien lo que le toca, y en este sitio todo el contenido está en el HTML sin JavaScript. Pero no conecta tus páginas entre sí ni escribe contenido útil por ti: ninguno de los ocho hallazgos anteriores es un defecto de Next.js.
¿Cómo se hace una auditoría SEO en Next.js?
Empieza por el HTML real: cada URL del sitemap debe responder 200, con un título, una descripción y un canonical correctos. Después rastrea los enlaces desde la portada, comprueba la reciprocidad de hreflang y ejecuta Lighthouse sobre un ejemplo de cada plantilla de página. Termina con Search Console, la única fuente sobre la indexación y las consultas reales. El script de este artículo cubre el rastreo.
¿Un 100 en SEO en Lighthouse garantiza un buen posicionamiento?
No. Indica que una página cumple diez reglas básicas, y el propio Lighthouse recuerda que muchos factores no se puntúan. La relevancia del contenido, los enlaces que recibes y la competencia por una consulta no forman parte de esa puntuación.
¿Hacen falta enlaces entre idiomas si hreflang ya está configurado?
Sí, Google lo recomienda. Hreflang indica qué versión mostrar a cada público, mientras que un enlace ofrece un camino a los rastreadores y a los visitantes que llegan al idioma equivocado. Cumplen funciones distintas.
¿Se penaliza un título de más de 60 caracteres?
No. Google no fija ningún límite de longitud y corta lo que muestra según el ancho de la pantalla. Los 60 caracteres son una referencia para reducir ese riesgo.
¿Hace falta un archivo llms.txt para aparecer en las respuestas de la IA?
Para Google, no: «There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary.» En ChatGPT, lo que puedes verificar es que no bloqueas OAI-SearchBot: según OpenAI, un sitio que lo bloquea deja de aparecer en las respuestas de su búsqueda.
Y ahora, ¿qué?
Ejecuta el script en tu sitio, aunque tu puntuación sea perfecta. Después compara lo que encuentre con Search Console: ahí sabrás qué importa de verdad para tus páginas.
Si tu sitio necesita este trabajo, mi servicio freelance de React y Next.js cubre el rediseño front-end, el rendimiento y el SEO técnico. Si estás contratando, la sección de Next.js de mi página de contratación explica lo que aporto a un equipo, y mi perfil resume mi trayectoria.
También puedes leer cómo construí este portafolio y el tutorial de agentes de IA con LangChain, cuyo código ejecuté de principio a fin.
Fuentes
- Google Search Central: nombres de sitio, enlaces de título, sitios multirregionales y multilingües, versiones localizadas, contenido útil, funciones de IA, cambios en la documentación, cómo funciona Googlebot
- Next.js: generateMetadata, JSON-LD, inlineCss
- Lighthouse 12.8.2: configuración por defecto, auditoría crawlable-anchors, auditoría hreflang
- Otros: rastreadores de OpenAI, IndexNow, redirección de dominios en Vercel