Réponse courte
Un score SEO de 100 dans Lighthouse prouve qu'une page passe dix contrôles. Il ne dit rien de ce qui se passe entre les pages. Le 8 novembre 2026, mon portfolio Next.js obtenait 100 sur les six modèles de page testés, alors que 61 de ses 89 URL n'étaient atteignables par aucun lien depuis l'accueil. Pour voir ce type de problème, il faut crawler tout le site, et le script que j'ai utilisé est plus bas. Les corrections sont trop récentes pour que j'aie des données de trafic : je n'annonce donc aucun gain.
Ce que j'ai audité, et comment
Le site est celui que vous lisez : Next.js 15 avec l'App Router, des pages statiques, trois langues et quelques mini-projets, le tout hébergé sur Vercel. L'article sur sa construction détaille son architecture.
L'audit a combiné quatre sources :
- Lighthouse 12.8.2, en mobile, sur six modèles de page en production : SEO 100, accessibilité 100, bonnes pratiques 100, performance 99.
- Un crawl des 89 URL du sitemap : statuts HTTP, métadonnées, hreflang, données structurées et liens internes.
- La lecture du code et des articles, avec un test des 45 liens externes cités.
- La documentation de Google et de Next.js, pour séparer les règles réelles des habitudes du métier.
Cet audit a trois limites :
- Il n'utilise ni la Search Console ni les données terrain de CrUX. Il décrit les conditions de référencement, pas les positions ni le trafic.
- Les mesures « avant » viennent de la production, et les mesures « après » d'un build local de la version corrigée.
- J'ai mené l'audit et les corrections avec un agent IA (Claude Code), puis j'ai relu et validé le résultat. Les erreurs décrites sont bien celles de mon site.
Ce que Lighthouse contrôle vraiment
La catégorie SEO de Lighthouse compte dix audits notés, et chacun regarde une seule page :
| Audit | Ce qu'il vérifie |
|---|---|
is-crawlable | Rien n'interdit l'indexation de la page |
http-status-code | La page répond avec un statut de succès |
document-title | La page a un <title> |
meta-description | La page a une meta description |
link-text | Les textes de lien sont descriptifs |
crawlable-anchors | Les balises <a> présentes ont un href exploitable |
robots-txt | Le fichier robots.txt est valide |
image-alt | Les images ont un attribut alt |
hreflang | Les codes de langue sont valides et les URL absolues |
canonical | Le canonical est valide et sans conflit |
Un onzième audit, structured-data, se fait à la main et ne compte pas dans le score.
L'outil ne s'en cache pas. Sa catégorie SEO parle de conseils de base (« basic search engine optimization advice ») et rappelle qu'il existe « many additional factors Lighthouse does not score ». Un contrôle page par page ne peut pas répondre à ces questions :
- Un lien mène-t-il à cette page ?
- Deux pages portent-elles le même titre ?
- La version espagnole renvoie-t-elle à la version française ?
- Mes liens internes mènent-ils à des pages que j'ai exclues de l'index ?
- Le code publié dans mes articles tourne-t-il encore ?
Huit constats, du plus important au plus anodin
1. Trois îles, une par langue
En partant de /, un robot trouvait les 28 pages anglaises et s'arrêtait là. Depuis /fr, il trouvait les 35 pages françaises, et depuis /es, les 26 pages espagnoles. Dans tout le site, aucune balise <a> ne reliait deux langues.
La cause tient en un élément HTML : mon sélecteur de langue était un <button>. Pour un visiteur, il fonctionnait très bien, sans rechargement. Pour un robot, il n'offrait aucun chemin. crawlable-anchors ne pouvait rien signaler, puisqu'il contrôle les <a> présents dans la page.
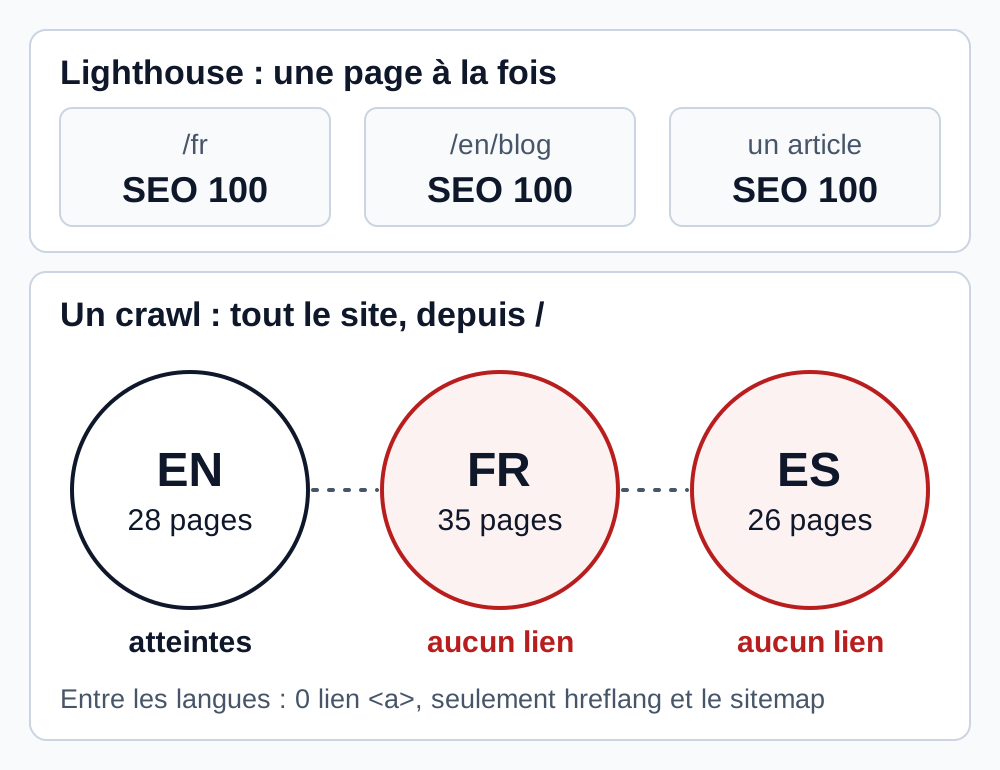
Ces pages n'étaient pas invisibles pour autant, car le sitemap et le hreflang permettent de les découvrir. Sans les données de la Search Console, je ne peux pas dire ce que cette situation a coûté. La recommandation de Google est pourtant claire : « Consider adding hyperlinks to other language versions of a page. » Le hreflang déclare une équivalence, alors qu'un lien offre un chemin, au robot comme au visiteur arrivé sur la mauvaise langue.
Le correctif garde le comportement au clic et ajoute un vrai lien :
// components/language-provider.tsx
export function LanguageLink({
  locale,
  onNavigate,
  ...props
}: ComponentProps<"a"> & { locale: BlogLanguage; onNavigate?: () => void }) {
  const { changeLanguage } = useLanguage();

  return (
    <a
      {...props}
      hrefLang={locale}
      lang={locale}
      onClick={(event) => {
        // Cmd/Ctrl-clic ou Maj-clic : le navigateur ouvre le lien normalement
        if (event.metaKey || event.ctrlKey || event.shiftKey || event.altKey) return;
        event.preventDefault();
        onNavigate?.();
        changeLanguage(locale); // la même transition qu'avant, sans rechargement
      }}
    />
  );
}
Reste le cas des articles : leur slug change d'une langue à l'autre, et le header ne connaît la traduction qu'une fois côté client. J'ai donc ajouté sous le titre de chaque article traduit une ligne rendue par le serveur, « Aussi disponible en English · Español ». Elle sert au lecteur, et le robot peut la suivre.
Le hreflang, lui, n'était pas en cause. Dans l'App Router, il passe par alternates, et chaque version doit se citer elle-même en plus de citer les autres :
export async function generateMetadata(): Promise<Metadata> {
  return {
    alternates: {
      canonical: "https://www.example.com/fr/blog/mon-article",
      languages: {
        fr: "https://www.example.com/fr/blog/mon-article",
        en: "https://www.example.com/en/blog/my-article",
        es: "https://www.example.com/es/blog/mi-articulo",
        "x-default": "https://www.example.com/en/blog/my-article",
      },
    },
  };
}
2. Un nom de site déclaré à la mauvaise adresse
Le nom affiché au-dessus d'un résultat Google s'appuie notamment sur le balisage WebSite. La règle est précise : « The WebSite structured data must be on the home page of the site. » Et Google définit cette page : « By home page, we mean the domain or subdomain level root URI. » Il ajoute même : « Google Search does not support site names at the subdirectory level. »
Sur les 89 URL, mon balisage déclarait /en, /fr ou /es selon la langue, soit trois sites différents et aucun à la racine. Le JSON-LD restait valide et Lighthouse ne note pas les données structurées, donc rien ne pouvait le signaler.
Je l'ai remplacé par une seule entité, identique dans toutes les langues :
// lib/seo/jsonld.ts
const WEBSITE_ID = `${SITE_URL}/#website`;

export function websiteNode(): Node {
  return {
    "@type": "WebSite",
    "@id": WEBSITE_ID,
    url: `${SITE_URL}/`,
    name: SITE_NAME,
    inLanguage: LOCALES.map((locale) => LOCALE_TO_LANGUAGE_TAG[locale]),
    publisher: { "@id": PERSON_ID },
  };
}
Un détail propre à ce site : / sert l'anglais et son canonical vise /en. Google demande justement le même balisage sur tous les doublons : « make sure that you're using the same structured data on all page duplicates, not just on the canonical page. » L'effet ne sera observable qu'après le déploiement, car c'est Google qui choisit le nom affiché.
3. 61 titres allongés sans que le code le montre
Ce site suit une règle simple : 60 caractères au maximum pour le seoTitle d'un article. Elle était respectée, et pourtant 61 des 89 titres rendus dépassaient cette limite, jusqu'à 80 caractères. La ligne responsable se trouve dans le layout racine :
// lib/root-metadata.ts
title: {
  default: `${SITE_NAME} — Full-Stack Developer`,
  template: `%s | ${SITE_NAME}`,
},
title.template ajoute la marque à chaque page sans que le code de la page le laisse voir. Il faut donc lire les titres rendus, pas ceux du code.
Ce n'est pas une pénalité. Google précise qu'il n'y a pas de limite de longueur (« there's no limit on how long a <title> element can be ») et qu'il tronque le titre si nécessaire (« truncated in Google Search results as needed, typically to fit the device width »). Le risque se limite à une fin de titre coupée. Le correctif ne garde donc la marque que si elle tient :
// lib/seo/metadata.ts
const MAX_TITLE_LENGTH = 60;
const BRAND_SUFFIX = ` | ${SITE_NAME}`;

export function resolveTitle(title: string, absolute = false): Metadata["title"] {
  return absolute || title.length + BRAND_SUFFIX.length > MAX_TITLE_LENGTH
    ? { absolute: title } // ignore le template du layout
    : title;
}
Le seuil de 60 est une convention de ce site, pas une règle de Google.
4. Des liens vers des pages que j'avais moi-même exclues
Dix-huit articles de ce blog sont en noindex : des sujets de tendance trop génériques pour mériter l'index. Pourtant, 9 liens placés dans 7 articles indexables menaient à 6 d'entre eux. Ces liens répondaient 200, donc aucun contrôle de page ne pouvait les signaler.
Il n'y a pas de pénalité à la clé, mais le message est contradictoire : je demande à Google d'ignorer une page tout en y envoyant les lecteurs de mes meilleurs articles. J'ai remplacé ces liens par une page indexable qui sert mieux le propos, ou je les ai retirés.
Ce problème revient dès qu'on écrit un nouvel article. J'en ai donc fait une erreur bloquante dans le contrôle qui tourne en CI :
// scripts/check-seo.mjs
} else if (!validPaths.has(pathname) && !publicFile(pathname)) {
  error(file, `broken internal link: ${href}`);
} else if (!fromNoindex && isNoindexArticle(pathname)) {
  error(file, `link to a noindex article: ${href}`);
}
5. Trois pages de thème pour le même contenu
Le blog français avait quatre pages de thème. Trois d'entre elles partageaient 9 à 10 de leurs 12 articles, et deux ne recevaient qu'un seul lien interne. Trois adresses pour presque la même liste : c'est exactement le genre de page qui n'apporte rien.
J'ai fusionné automatisation et productivite-developpeur dans agents-ia, repris leur texte utile et ajouté des redirections permanentes, que Next.js sert en 308 :
// next.config.ts
...[
  ...getMergedPageRedirects(),
  ...getMergedTopicHubRedirects(),
  ...getSectionRedirects(),
].map((redirect) => ({ ...redirect, permanent: true })),
Il reste deux pages de thème réellement distinctes : les agents IA et Next.js.
6. Du code publié qui ne tournait plus
C'est le constat le moins flatteur, et aucun outil SEO ne pouvait le faire :
- Mon tutoriel LangChain importait
AgentExecutoretcreate_react_agentdepuislangchain.agents, ce qui échoue avec LangChain 1.x. Il renvoyait aussi vers un dépôt GitHub en 404. - L'article sur SmartDAM appelait
api-inference.huggingface.co, un hôte qui n'existe plus. - L'article sur ce portfolio décrivait encore Next.js 13 et un script de sitemap disparu depuis longtemps.
Google pose pourtant la question : « Does the content have any easily-verified factual errors? » Et un développeur dont le copier-coller échoue a peu de raisons de revenir.
J'ai réécrit le tutoriel pour LangChain 1.x et j'ai exécuté chaque fichier dans un environnement Python vierge, avec un modèle factice et de vraies bases SQLite et PostgreSQL. Ces exécutions ont trouvé ce qu'une relecture laissait passer :
InMemoryVectorStorea besoin denumpy, absent de la commande d'installation.- Un client créé à l'import échouait avant le
load_dotenv(). ModelRetryMiddlewaretransforme par défaut l'échec du modèle en message d'IA, si bien que l'API du tutoriel répondait 200 alors que le modèle était en panne.
Pour SmartDAM, j'ai remplacé l'URL par celle du routeur Hugging Face, sans l'avoir testée avec un vrai jeton. Une note datée le signale dans l'article.
7. Des fautes qu'un correcteur simple ne voit pas
Dans les articles français, un contrôle au dictionnaire a signalé plus de 200 occurrences, surtout des accents manquants. Les pires fautes étaient ailleurs : « C'est le piégé », « lancé des checks », « On commencé ». Chaque mot existe, donc un dictionnaire ne dit rien. L'historique git montre d'où elles viennent : une ancienne passe automatique d'ajout d'accents, qui les a introduites toutes les trois dans le même commit.
Google demande : « Does the content have any spelling or stylistic issues? » Je les ai corrigées une par une, en lisant chaque phrase concernée plutôt qu'en remplaçant à l'aveugle, car beaucoup de mots signalés sont corrects, surtout en espagnol, où « integra » ou « publica » sont de vraies formes verbales.
8. Les petites incohérences
| Constat | Correctif |
|---|---|
Domaine nu en 307, temporaire, et deux sauts depuis http:// | Se règle dans le tableau de bord Vercel, pas dans le code |
Six liens internes vers /, qui n'est pas une URL canonique | Liens directs vers /en |
/fr/projets, /en/projects, /es/proyectos et /fr/blog/themes en 404 | Redirections 308 vers la liste correspondante |
| Descriptions OpsPilot de 183 et 172 caractères, titre sans sujet | Titre et description écrits pour la recherche, page inchangée |
Sitemap sans x-default, alors que le HTML en avait un | Ajouté |
llms.txt, ai-profile.json et flux RSS indexables | X-Robots-Tag: noindex, fichiers toujours accessibles |
| Branche sur le user-agent dans le middleware | Retirée : la réponse dépend d'Accept-Language, jamais du robot |
| Composant client important toutes les pages d'atterrissage pour trois libellés | Libellés passés en prop, JavaScript de la page blog de 17,7 à 4,8 Ko |
Ce que j'ai mesuré et laissé tel quel
Un audit sert aussi à ne pas toucher à ce qui ne le justifie pas.
inlineCss. Cette option place le CSS dans le HTML, et il reste aussi dans le flux RSC, ce qui semble être un gaspillage. J'ai comparé les deux réglages sur un build local, avec cinq mesures par variante. Le FCP gagne 50 à 70 ms de façon stable, et l'écart sur le LCP se perd dans le bruit de mesure, pour 12 Ko de plus sur l'accueil et 48 Ko sur un article. Le HTML reste loin de la limite de 2 Mo de Googlebot. J'ai gardé l'option.
Les FAQ. Google n'affiche plus de résultats enrichis FAQ depuis mai 2026. Ajouter une FAQ pour occuper plus de place dans les résultats ne sert donc plus à rien. Je garde celles qui répondent à de vraies questions.
llms.txt. Pour ses fonctionnalités IA, Google est explicite : « You don't need to create new machine readable files, AI text files, or markup ». Je garde ce fichier parce qu'il se génère tout seul, sans en attendre d'effet.
IndexNow. Un script manuel prévient Bing et les autres moteurs participants après un déploiement. Google n'y participe pas, et je n'ai trouvé aucune preuve d'un effet sur les citations des assistants IA.
La redirection de langue sur /. Google conseille d'éviter les redirections automatiques (« Avoid automatically redirecting »). Je la garde sur la seule racine : un navigateur réglé en français ou en espagnol y est envoyé vers sa langue, et un robot, qui n'envoie pas de préférence, reçoit l'anglais. Chaque version garde sa propre URL, accessible directement et par un lien. C'est un compromis assumé.
Avant et après
La colonne « Avant » vient de la production, la colonne « Après » d'un build local de la version corrigée.
| Contrôle | Avant | Après |
|---|---|---|
| Lighthouse SEO, six modèles de page | 100 | 100 |
| URL inatteignables depuis l'accueil | 61 sur 89 | 0 sur 90 |
| Titres de plus de 60 caractères | 61 | 0 |
| Descriptions hors de 70 à 160 caractères | 2 | 0 |
Pages déclarant WebSite hors de la racine | 89 | 0 |
| Liens vers des pages noindex | 9 | 0 |
Liens internes vers / | 6 | 0 |
Le score n'a pas bougé, et c'est tout le sujet : il ne voyait pas la différence. Ce tableau décrit l'état du site, pas un résultat de recherche. Les positions et le trafic se liront dans la Search Console, plusieurs semaines après le déploiement.
Un script pour auditer votre site Next.js
Rien dans ce script n'est propre à Next.js : il fonctionne sur tout site doté d'un sitemap. Copiez-le dans un fichier seo-audit.mjs, puis lancez-le :
# En production
node seo-audit.mjs https://www.example.com

# Sur un build local : le script remplace l'origine du sitemap par cette adresse
npx next build && npx next start -p 3000
node seo-audit.mjs http://localhost:3000
Il lit le sitemap, y compris un index de sitemaps, demande chaque page sans exécuter de JavaScript, puis applique les règles de cet article. La version qui tourne sur ce site en a quelques-unes de plus, comme le poids du HTML et la profondeur des clics.
// seo-audit.mjs : crawle un sitemap et signale ce qu'un score page par page ne peut pas voir.
// node seo-audit.mjs https://www.example.com
// node seo-audit.mjs http://localhost:3000 un build local dont le sitemap liste les URL de production
// Aucune dépendance, Node 20 ou plus. Il lit le HTML envoyé par le serveur, sans exécuter de JavaScript.
const base = (process.argv[2] ?? "http://localhost:3000").replace(/\/$/, "");
const problems = new Map();
const report = (rule, detail) => problems.set(rule, [...(problems.get(rule) ?? []), detail]);
const attr = (tag = "", name) => tag.match(new RegExp(`\\s${name}="([^"]*)"`, "i"))?.[1];
const tags = (html, name) => html.match(new RegExp(`<${name}\\b[^>]*>`, "gi")) ?? [];
const decode = (text = "") =>
text
.replace(/&#x([0-9a-f]+);/gi, (_, hex) => String.fromCodePoint(parseInt(hex, 16)))
.replace(/&#(\d+);/g, (_, code) => String.fromCodePoint(Number(code)))
.replace(/"/g, '"')
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/&/g, "&");
// Une même page doit toujours avoir la même clé : ni paramètres, ni fragment, ni barre finale
const clean = (url, from) => {
const { origin, pathname } = new URL(decode(url), from);
return origin + pathname.replace(/(?<=.)\/$/, "");
};
const local = (url) => base + new URL(url).pathname;
async function get(url, redirect = "manual") {
const response = await fetch(url, { redirect, headers: { "user-agent": "SeoAudit/1.0" } });
return {
status: response.status,
location: response.headers.get("location"),
robots: response.headers.get("x-robots-tag") ?? "",
html: await response.text(),
};
}
async function readSitemap(url) {
const { html: xml } = await get(url, "follow");
const entries = [...xml.matchAll(/<loc>\s*([^<\s]+)\s*<\/loc>/g)].map((match) => clean(match[1]));
if (!xml.includes("<sitemapindex")) return entries;
return (await Promise.all(entries.map((entry) => readSitemap(local(entry))))).flat();
}
const urls = [...new Set(await readSitemap(`${base}/sitemap.xml`))];
if (urls.length === 0) throw new Error("Aucune URL dans le sitemap");
const origin = new URL(urls[0]).origin;
function parse(url, { html, robots }) {
const links = tags(html, "link");
const meta = (name) => attr(tags(html, "meta").find((tag) => attr(tag, "name") === name), "content");
const targets = tags(html, "a").flatMap((tag) => {
try {
const target = clean(attr(tag, "href") ?? "", url);
return target.startsWith(`${origin}/`) || target === origin ? [target] : [];
} catch {
return [];
}
});
return {
title: decode(html.match(/<title\b[^>]*>([\s\S]*?)<\/title>/i)?.[1]),
description: decode(meta("description")),
noindex: /noindex/i.test(`${meta("robots")} ${robots}`),
canonicals: links.filter((tag) => attr(tag, "rel") === "canonical").map((tag) => clean(attr(tag, "href"), url)),
alternates: links.filter((tag) => attr(tag, "hreflang")).map((tag) => clean(attr(tag, "href"), url)),
h1: tags(html, "h1").length,
links: [...new Set(targets)],
};
}
function checkStructuredData(url, html) {
for (const [, json] of html.matchAll(/<script[^>]*ld\+json[^>]*>([\s\S]*?)<\/script>/gi)) {
try {
const nodes = [JSON.parse(json)].flat().flatMap((item) => item["@graph"] ?? [item]);
for (const node of nodes) {
if (node["@type"] === "WebSite" && new URL(node.url).pathname !== "/") {
report("Balisage WebSite hors de la racine du domaine", `${url} (${node.url})`);
}
}
} catch {
report("JSON-LD invalide", url);
}
}
}
// Une page à la fois
const pages = new Map();
const seen = new Map();
for (const url of urls) {
const response = await get(local(url));
if (response.status !== 200) {
report("URL du sitemap qui ne répond pas 200", `${url} (${response.status})`);
continue;
}
const page = parse(url, response);
pages.set(url, page);
checkStructuredData(url, response.html);
if (page.noindex) report("Page noindex dans le sitemap", url);
if (page.canonicals.length !== 1 || page.canonicals[0] !== url) report("Canonical différent de l'URL de la page", url);
if (page.h1 !== 1) report("Page sans H1 unique", `${url} (${page.h1})`);
if (page.title.length > 60) report("Titre de plus de 60 caractères (risque de troncature, pas une pénalité)", `${url} (${page.title.length})`);
const length = page.description.length;
if (length > 0 && (length < 70 || length > 160)) report("Description hors de 70 à 160 caractères", `${url} (${length})`);
for (const field of ["title", "description"]) {
const key = `${field}:${page[field]}`;
if (!page[field]) report(`Balise absente : ${field}`, url);
else if (seen.has(key)) report(`Balise en double : ${field}`, `${url} = ${seen.get(key)}`);
else seen.set(key, url);
}
}
// hreflang : chaque version se cite elle-même, et les versions citées doivent la citer en retour
for (const [url, page] of pages) {
if (page.alternates.length > 0 && !page.alternates.includes(url)) report("Groupe hreflang qui ne cite pas la page", url);
for (const other of page.alternates) {
if (!pages.has(other)) report("Cible hreflang absente du sitemap", `${url} -> ${other}`);
else if (!pages.get(other).alternates.includes(url)) report("hreflang non réciproque", `${url} -> ${other}`);
}
}
// Liens internes : où mènent-ils ?
const answers = new Map();
for (const [url, page] of pages) {
for (const target of page.links.filter((link) => !pages.has(link))) {
if (!answers.has(target)) answers.set(target, await get(local(target)));
const answer = answers.get(target);
if (answer.status >= 400) report("Lien vers une page introuvable", `${url} -> ${target} (${answer.status})`);
else if (answer.status >= 300) report("Lien vers une redirection", `${url} -> ${target} (${answer.status} vers ${answer.location})`);
else if (/<html/i.test(answer.html.slice(0, 500))) {
if (parse(target, answer).noindex) report("Lien vers une page noindex", `${url} -> ${target}`);
else report("Page indexable absente du sitemap", `${url} -> ${target}`);
}
}
}
// Quelles pages un robot atteint-il en suivant les liens depuis l'accueil ?
const home = parse(`${origin}/`, await get(`${base}/`, "follow"));
const reached = new Set(home.links);
for (const queue = [...reached]; queue.length > 0; ) {
for (const target of pages.get(queue.shift())?.links ?? []) {
if (!reached.has(target)) {
reached.add(target);
queue.push(target);
}
}
}
for (const url of pages.keys()) {
if (!reached.has(url) && url !== `${origin}/`) report("Page qu'aucun lien ne permet d'atteindre depuis l'accueil", url);
}
for (const [rule, items] of problems) {
console.log(`\n${rule} : ${items.length}`);
for (const item of items.slice(0, 5)) console.log(` ${item}`);
if (items.length > 5) console.log(` ... et ${items.length - 5} de plus`);
}
const total = [...problems.values()].reduce((sum, items) => sum + items.length, 0);
console.log(`\n${urls.length} URL, ${total} problèmes`);
process.exitCode = total > 0 ? 1 : 0;
Voici sa sortie, raccourcie, sur l'ancienne version de ce site. La règle « Page indexable absente du sitemap » désigne ici les liens vers / du constat 8.
Balisage WebSite hors de la racine du domaine : 89
  https://www.mouhssinelakhili.com/en (https://www.mouhssinelakhili.com/en)
  https://www.mouhssinelakhili.com/fr (https://www.mouhssinelakhili.com/fr)
  ...

Titre de plus de 60 caractères (risque de troncature, pas une pénalité) : 61
  https://www.mouhssinelakhili.com/fr/developpeur-full-stack-javascript-typescript-paris (67)
  https://www.mouhssinelakhili.com/es/ingeniero-full-stack-paris (64)
  ...

Description hors de 70 à 160 caractères : 2
  https://www.mouhssinelakhili.com/fr/projets/opspilot (183)
  https://www.mouhssinelakhili.com/es/proyectos/opspilot (172)

Page indexable absente du sitemap : 2
  https://www.mouhssinelakhili.com/en/blog/github-copilot-cloud-agent-explained-april-2026 -> https://www.mouhssinelakhili.com/
  https://www.mouhssinelakhili.com/en/blog/agent-command-centers-2026-developer-productivity -> https://www.mouhssinelakhili.com/

Lien vers une page noindex : 9
  https://www.mouhssinelakhili.com/en/blog/agent-command-centers-2026-developer-productivity -> https://www.mouhssinelakhili.com/en/blog/vibe-coding-field-report-2026
  https://www.mouhssinelakhili.com/en/blog/ai-orchestrator-battle-guide-2026 -> https://www.mouhssinelakhili.com/en/blog/ai-in-2026-autonomous-ai-agents-and-human-ai-collaboration
  ...

Page qu'aucun lien ne permet d'atteindre depuis l'accueil : 61
  https://www.mouhssinelakhili.com/fr
  https://www.mouhssinelakhili.com/es
  ...

89 URL, 224 problèmes
Le script renvoie un code de sortie 1 s'il trouve un problème, donc il peut aussi bloquer une CI. Il a ses limites :
- Il ne suit que les liens des pages du sitemap et ne teste aucun lien externe.
- Il ne lit pas
robots.txt. - Il voit le HTML du serveur : une page rendue côté client lui paraîtra presque vide, ce qui est déjà une information utile.
- Les seuils de 60 et de 70 à 160 caractères sont des repères, pas des règles de Google. Adaptez-les.
- Il envoie les requêtes une par une pour ménager l'hébergement. Lancez-le uniquement sur vos propres sites.
Checklist SEO pour un site Next.js
-
Crawlez depuis l'accueil. Toute page du sitemap doit être atteignable par des liens.
-
Cherchez votre sélecteur de langue dans le HTML. Il doit contenir un
<a href>, car un<button>ou un<select>n'offre aucun chemin. -
Lisez vos titres rendus, car
title.templateles allonge :curl -s https://www.example.com/page | grep -o '<title>[^<]*</title>' -
Contrôlez le balisage
WebSite. Sonurldoit être la racine du domaine, avec le même balisage sur toutes les versions de l'accueil. -
Testez les redirections de domaine. Visez un seul saut, permanent (301 ou 308) :
curl -sI http://example.com | grep -iE '^(HTTP|location)' curl -sI https://example.com | grep -iE '^(HTTP|location)' -
Vérifiez que le contenu arrive sans JavaScript. Un résultat de 0 signale un problème :
curl -s https://www.example.com/page | grep -c "une phrase de la page" -
Refusez en CI les liens vers des pages noindex. Ce sont les plus faciles à réintroduire.
-
Exécutez le code de vos tutoriels dans un environnement vierge, au moins à chaque version majeure des bibliothèques citées.
-
Mesurez avant d'optimiser. Un réglage comme
inlineCssse compare, il ne se devine pas. -
Confrontez le tout à la Search Console. Les pages indexées et les requêtes réelles restent la seule mesure du résultat.
Questions fréquentes
Comment faire un audit SEO d'un site Next.js ?
Commencez par le HTML réel : chaque URL du sitemap doit répondre 200, avec un titre, une description et un canonical corrects. Crawlez ensuite les liens depuis l'accueil, contrôlez la réciprocité du hreflang et lancez Lighthouse sur un exemple de chaque modèle de page. Terminez par la Search Console, seule source pour l'indexation et les requêtes réelles. Le script de cet article couvre le crawl.
Un score Lighthouse de 100 en SEO garantit-il un bon classement ?
Non. Il indique qu'une page respecte dix règles de base, et Lighthouse rappelle lui-même que de nombreux facteurs ne sont pas notés. La pertinence du contenu, les liens reçus et la concurrence sur la requête ne figurent pas dans ce score.
Next.js est-il bon pour le SEO ?
Oui pour ce qui dépend du framework : HTML rendu côté serveur, API Metadata, sitemap et robots générés. Sur ce site, tout le contenu est présent dans le HTML sans JavaScript. Mais Next.js ne relie pas vos pages entre elles et n'écrit pas de contenu utile à votre place. Aucun des huit constats ci-dessus n'est un défaut du framework.
Faut-il des liens entre les langues si le hreflang est déjà en place ?
Oui, Google le conseille. Le hreflang indique quelle version montrer à quel public, alors qu'un lien offre un chemin aux robots et aux visiteurs arrivés sur la mauvaise langue. Les deux ont des rôles différents.
Un titre de plus de 60 caractères est-il pénalisé ?
Non. Google ne fixe aucune limite de longueur et tronque l'affichage selon la largeur de l'écran. Les 60 caractères sont un repère pour limiter ce risque.
Faut-il un fichier llms.txt pour apparaître dans les réponses des IA ?
Pas pour Google : « There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary. » Pour ChatGPT, le point vérifiable est de ne pas bloquer OAI-SearchBot : d'après OpenAI, un site qui le bloque n'apparaît plus dans les réponses de sa recherche.
Et maintenant ?
Lancez le script sur votre site, même si votre score est parfait. Ensuite, comparez ce qu'il trouve avec la Search Console : c'est là que vous saurez ce qui compte vraiment pour vos pages.
Si votre site a besoin de ce travail, mon offre freelance React et Next.js couvre la refonte front-end, la performance et le SEO technique. Si vous recrutez, la section Next.js de ma page recrutement détaille ce que j'apporte à une équipe, et mon profil présente mon parcours.
À lire aussi : l'architecture d'un SaaS avec Next.js, TypeScript et PostgreSQL, la checklist SEO d'un portfolio de développeur et le parcours Next.js, React et TypeScript.
Sources
- Google Search Central : noms de site, liens de titre, sites multirégionaux et multilingues, versions localisées, contenu utile, fonctionnalités IA, mises à jour de la documentation, fonctionnement de Googlebot
- Next.js : generateMetadata, JSON-LD, inlineCss
- Lighthouse 12.8.2 : configuration par défaut, audit crawlable-anchors, audit hreflang
- Autres : robots d'OpenAI, IndexNow, redirection de domaines sur Vercel